如果数据库是基于 PostgreSQL 开发的,为了适配其他各种类型的数据库(如 DB2、Oracle 等),我们肯定会碰到词法和语法的各种问题,例如:缺少适配的 token、语法规则的增删改、扫描标识符正则表达式的调整,以及各种移进-归约(shift/reduce)或归约-归约(reduce/reduce)冲突等。对这些问题,很多人感到茫然,不知如何入手。
接下来,我将以 HALO 数据库适配 DB2 时遇到的一个典型语法问题为例进行说明:在 DB2 中,ORDER 关键字可以合法地用作表名或列名。例如以下 SQL:
CREATE TABLE order ( id int,  order VARCHAR(32));
INSERT INTO order VALUES(1, 'JACK') ,(2,'LEO');
SELECT id, order FROM order;
在原生 DB2 中执行成功,输出如下:
(instance:DB2INST1, database:):CREATE TABLE order ( id int,  order VARCHAR(32));@
DB20000I  The SQL command completed successfully.
(instance:DB2INST1, database:):INSERT INTO order VALUES(1, 'JACK') ,(2,'LEO');@
DB20000I  The SQL command completed successfully.
(instance:DB2INST1, database:):SELECT id, order FROM order;@
ID          ORDER
----------- --------------------------------
          1 JACK
          2 LEO
  2 record(s) selected.
但在 PostgreSQL(或 HALO)中执行会报错:
ERROR: syntax error at or near "order" at character 14这是因为 ORDER 是 PostgreSQL 的保留关键字(RESERVED_KEYWORD),仅允许在特定上下文(如 ORDER BY 子句)中使用,不能直接作为普通标识符。
一种直观的解决方法是在 SQL 中使用双引号转义:
CREATE TABLE "order" ( id INT,  "order" VARCHAR(32));
INSERT INTO "order" VALUES(1, 'JACK') ,(2,'LEO');
SELECT id, "order" FROM "order";
但这种方法存在明显缺点:
1. 仅支持小写 "order",无法兼容大小写混合或全大写写法;
2. 若 SQL 中包含 ORDER BY,字符串替换可能误改关键字;
3. 字符串常量中若含 'order',会被错误替换;
4. 需多次遍历 SQL 字符串,影响执行效率;
5. 代码可读性差,维护困难;
6. 随着语境复杂化,补丁式修改将导致逻辑臃肿、耦合度高、维护成本剧增。
因此,更优方案是在查询分析模块内部解决该问题。根据查询处理流程,越早处理(如词法/语法阶段),系统耦合越低,扩展性越好。
查询处理的流程架构
SQL 命令由后台进程接收后,首先进入查询分析模块,进行词法、语法和语义分析。简单 DDL 交由功能模块处理;复杂 SELECT/DML 则构建查询树 → 查询重写 → 路径生成(考虑访问方式、连接顺序等)→ 生成执行计划 → 执行。
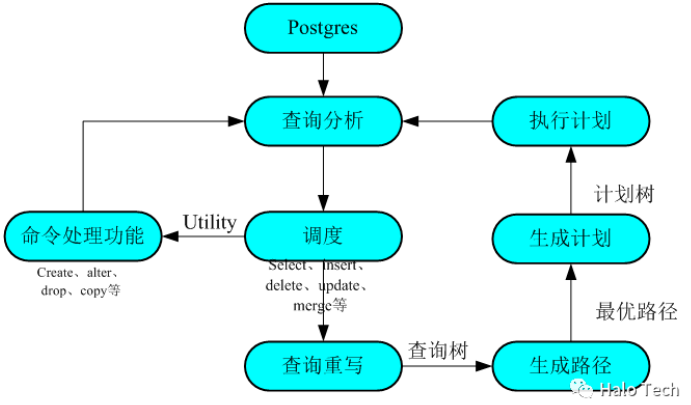
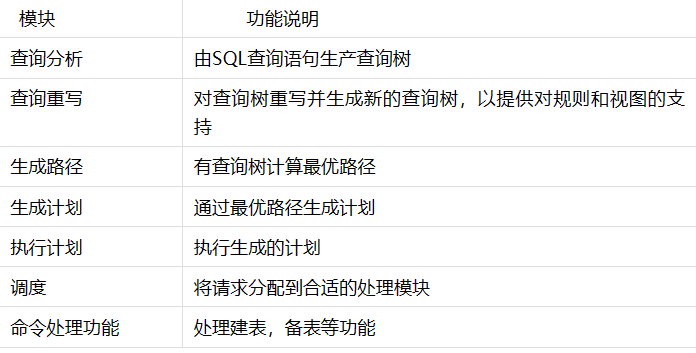
各模块简要说明如下:
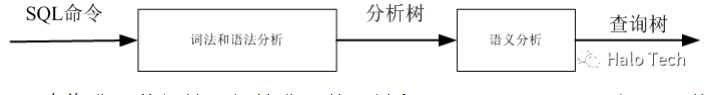
查询分析的流程框架
查询分析是查询编译的第一步,包含词法分析、语法分析和语义分析。其中词法与语法分析由 Flex(Lex)和 Bison(Yacc)工具实现。用户输入的 SQL 字符串经分析后生成原始分析树(raw parse tree),再经语义分析得到查询树。
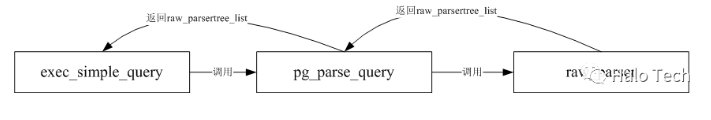
入口函数为 exec_simple_query → pg_parse_query → raw_parser,后者调用 scanner 和 parser 生成分析树链表。
PostgreSQL 词法与语法分析相关核心文件包括:
[1] kwlist.h:声明关键字列表
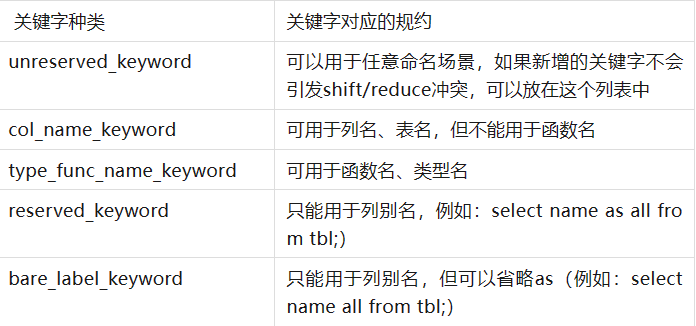
例如:
PG_KEYWORD("order", ORDER, RESERVED_KEYWORD, AS_LABEL)[2] kwlookup.cpp:实现 ScanKeywordLookup 函数,通过二分查找判断输入是否为关键字;
[3] scanup.c:提供词法辅助函数,如 downcase_truncate_identifier、scanner_isspace 等;
[4] scan.l:Flex 词法规则文件,编译生成 scan.c;
[5] gram.y:Bison 语法规则文件,编译生成 gram.c;
[6] check_keywords.pl:校验 gram.y 与 kwlist.h 中关键字一致性;
[7] parser.c:提供 raw_parser 入口函数及 base_yylex 词法过滤逻辑。
raw_parser 主要流程:初始化 scanner 和 parser,调用 base_yyparse 进行解析。
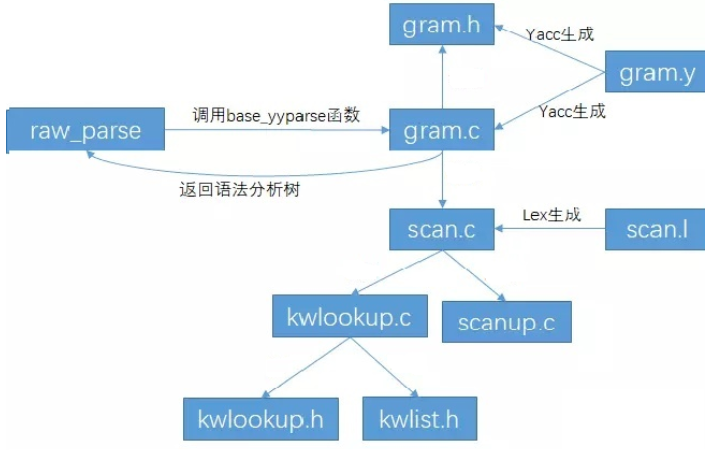
词法(Flex)与语法(Bison)工作原理简述
• Flex:将 .l 文件中的正则表达式规则编译为 C 代码,识别保留字、标识符、操作符等 token;
• Bison:基于 LALR(1) 文法生成语法分析器,采用自底向上的移进-归约策略,通过调用 yylex 获取 token 并执行语义动作(Semantic Action)。
通过词法与语法分析解决语法问题
适配 DB2 通常需修改 gram.y 和 kwlist.h。例如添加 DB2 关键字 MICROSECOND:
1. 在 kwlist.h 中按 ASCII 顺序插入(避免冲突):
PG_KEYWORD("microsecond", MICROSECOND_P, UNRESERVED_KEYWORD, AS_LABEL)2. 在 gram.y 中:
%token <keyword> ... MICROSECOND_P ...

unreserved_keyword:
        ABORT_P
      | ABSOLUTE_P
      ...
      | MICROSECOND_P

%type <list> interval_microsecond

interval_microsecond:
      MICROSECOND_P
        { $ = list_make1(makeIntConst(INTERVAL_MASK(SECOND), @1)); };
对于词法规则修改(如 DB2 支持标识符含 '#'):
SELECT * FROM USER#;需修改 scan.l:
ident_start    [A-Za-z\200-\377_]
ident_cont     [A-Za-z\200-\377_0-9\$\#]   /* 添加 # 符号 */
回到 ORDER 关键字问题:若简单将其改为 UNRESERVED_KEYWORD,会导致 ORDER BY 子句产生大量移进-归约冲突:
gram.y: error: shift/reduce conflicts: 18 found, 0 expected
gram.y: error: reduce/reduce conflicts: 5 found, 0 expected
解决方案:引入“伪 token”(pseudo-token)机制。伪 token 仅在 gram.y 中声明,无实际 keyword 值,不受关键字分类限制,仅作语法占位。
在 gram.y 中声明:
%token ORDER_Q关键在于利用 parser.c 中的 base_yylex 函数实现 lookahead(向前看一个 token)逻辑:当当前 token 为 ORDER 时,预读下一个 token;若非 BY,则替换为 ORDER_Q,否则保留 ORDER。
修改 base_yylex 如下:
base_yylex(YYSTYPE *lvalp, YYLTYPE *llocp, core_yyscan_t yyscanner)
{
  base_yy_extra_type *yyextra = base_yyget_extra(yyscanner);
  int cur_token, next_token, cur_token_length;
  YYLTYPE cur_yylloc;

  /* 获取当前 token */
  if (yyextra->have_lookahead) {
    // ... 从 lookahead 缓存取
  } else {
    cur_token = base_core_yylex(&(lvalp->core_yystype), llocp, yyscanner);
  }

  /* 判断是否需要 lookahead */
  switch (cur_token) {
    case ORDER: cur_token_length = 5; break;
    default: return cur_token;
  }

  /* 保存当前位置,预读下一个 token */
  cur_yylloc = *llocp;
  next_token = base_core_yylex(&(yyextra->lookahead_yylval), llocp, yyscanner);
  yyextra->lookahead_token = next_token;
  yyextra->lookahead_yylloc = *llocp;
  *llocp = cur_yylloc;

  /* 恢复当前 token 字符串结尾 */
  yyextra->lookahead_end = yyextra->core_yy_extra.scanbuf + (*llocp).endpos;
  yyextra->lookahead_hold_char = *(yyextra->lookahead_end);
  *(yyextra->lookahead_end) = '\0';
  yyextra->have_lookahead = true;

  /* 根据 lookahead 决定是否替换 */
  switch (cur_token) {
    case ORDER:
      if (next_token != BY)
        cur_token = ORDER_Q;
      break;
    // 其他类似处理(如 NOT + BETWEEN → NOT_LA)
  }

  return cur_token;
}
最后,在 gram.y 中为 ORDER_Q 添加语法规则,使其可作为列名或表名,并返回字符串 "order"(支持大小写无关):
/* Column identifier --- names that can be column, table, etc names. */
ColId:
      IDENT                  { $ = $1; }
    | unreserved_keyword     { $ = pstrdup($1); }
    | col_name_keyword       { $ = pstrdup($1); }
    | ORDER_Q                { $ = pstrdup("order"); }
    ;
编译并重启后,测试命令成功执行,结果与 DB2 一致:
CREATE TABLE order (id int,  order VARCHAR(32));
INSERT INTO order VALUES(1, 'JACK'), (2,'LEO');
halodb2=# SELECT id, ORDER FROM ORDER;
 id | order
----+-------
  1 | jack
  2 | LEO
(2 rows)
总结:在适配多数据库方言时,词法与语法层的定制是不可避免的。上述第三种技巧(伪 token + lookahead)非常实用。例如,DB2 支持 int(12.32) 这类函数式类型转换,而 PostgreSQL 原生不支持;若直接修改关键字声明,常引发移进-归约冲突。此时,同样可通过 lookahead 区分上下文(如 char(Iconst) vs char(func_arg_list_opt)),从而完美解决冲突。
思考题:如何利用该方法解决 DB2 中 char(Iconst)(类型声明)与 char(func_arg_list_opt)(函数调用)之间的移进-归约冲突?