快速上手Halo数据库之分组复制
1. 说明
该功能可以在同一个集群里实现分组复制,每个每组可以包含多个节点、设置不同的同步级别。
如需启用分组复制,必须先配置同步复制参数 synchronous_standby_names 和 synchronous_commit,再按照需要配置 synchronous_standby_namesX 和 synchronous_commitX(X为1-4)。synchronous_commitX 设置的同步级别必须低于或者等于 synchronous_commit 设置的同步级别。
2. 背景
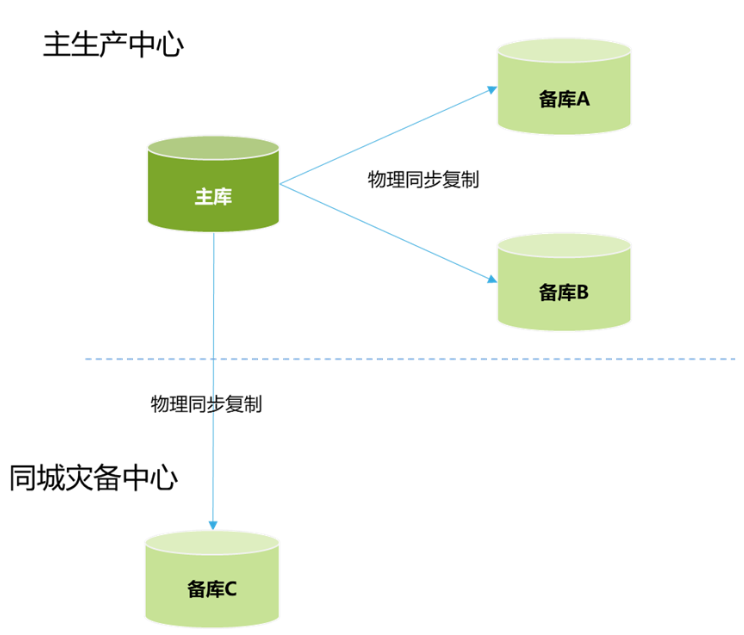
在一个典型的同城灾备集群中,可以将同中心备节点的同步级别设置为 remote_apply,同城灾备中心备节点的同步级别设置为 on,从而既可以实现同城 rpo=0(即故障恢复后不丢失数据,跟故障前的数据状态是一致的),又最大程度保证主库性能。
3. 配置
准备四台服务器
主库
node1: 10.16.16.155
从库
node2: 10.16.16.156
node3: 10.16.16.157
node4: 10.16.16.162
1、创建流复制用户
CREATE USER replica PASSWORD '123456' REPLICATION;2、修改 postgresql.conf
vi /data/halo/postgresql.conf
listen_addresses = 'localhost'   修改为 listen_addresses = '*'
----分组复制的配置:
synchronous_standby_names='1(node2,node4)'
synchronous_standby_names1='1(node3)'
synchronous_commit=remote_apply
synchronous_commit1=on
3、配置 pg_hba.conf
vi /data/halo/pg_hba.conf
host    replication     replica         10.16.16.0/24      md5
----做完1,2,3步需要重启数据库
pg_ctl restart4、主备库配置
vi /etc/hosts
10.16.16.155 node1 (主库ip)
10.16.16.156 node2  备库ip
10.16.16.157 node3  备库ip  --同城灾备
10.16.16.162 node4  备库ip
1、备库执行:
10.16.16.156:
pg_basebackup -F p -X stream -v -P -h 10.16.16.155 -U replica -D $PGDATA -R -C --slot node210.16.16.157:
pg_basebackup -F p -X stream -v -P -h 10.16.16.155 -U replica -D $PGDATA -R -C --slot node310.16.16.162:
pg_basebackup -F p -X stream -v -P -h 10.16.16.155 -U replica -D $PGDATA -R -C --slot node4注意事项:
将所有备库 postgresql.auto.conf 文件里的内容注释掉,因为 postgresql.auto.conf 文件的优先级高于 postgresql.conf

2、修改备库里的 /data/halo/postgresql.conf 文件
vi /data/halo/postgresql.conf
10.16.16.156:
primary_conninfo = 'user=replica password=123456 channel_binding=prefer host=10.16.16.155 port=1921 sslmode=prefer sslcompression=0 sslsni=1 ssl_min_protocol_version=TLSv1.2 gssencmode=disable krbsrvname=halo target_session_attrs=any application_name=node2'--启动
pg_ctl start查询:
show primary_conninfo;10.16.16.157:
primary_conninfo = 'user=replica password=123456 channel_binding=prefer host=10.16.16.155 port=1921 sslmode=prefer sslcompression=0 sslsni=1 ssl_min_protocol_version=TLSv1.2 gssencmode=disable krbsrvname=halo target_session_attrs=any application_name=node3'--启动
pg_ctl start查询:
show primary_conninfo;10.16.16.162:
primary_conninfo = 'user=replica password=123456 channel_binding=prefer host=10.16.16.155 port=1921 sslmode=prefer sslcompression=0 sslsni=1 ssl_min_protocol_version=TLSv1.2 gssencmode=disable krbsrvname=halo target_session_attrs=any application_name=node4'--启动
pg_ctl start查询:
show primary_conninfo;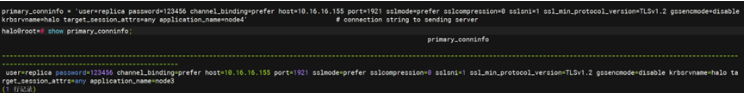
主库上查询流复制
select * from pg_stat_replication;
show synchronous_standby_names;
show synchronous_standby_names1;
show synchronous_commit;
show synchronous_commit1;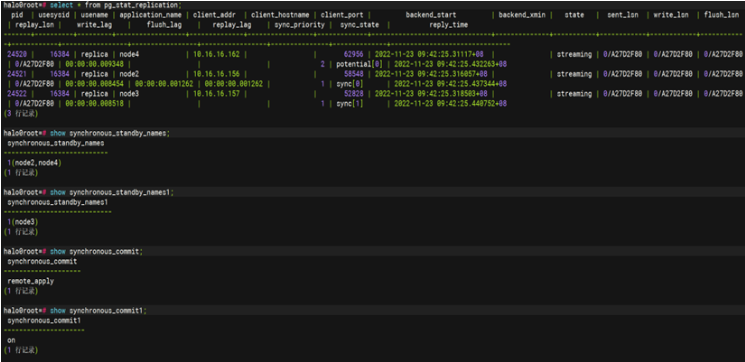
以上一个完整的分组复制就配置好了!